

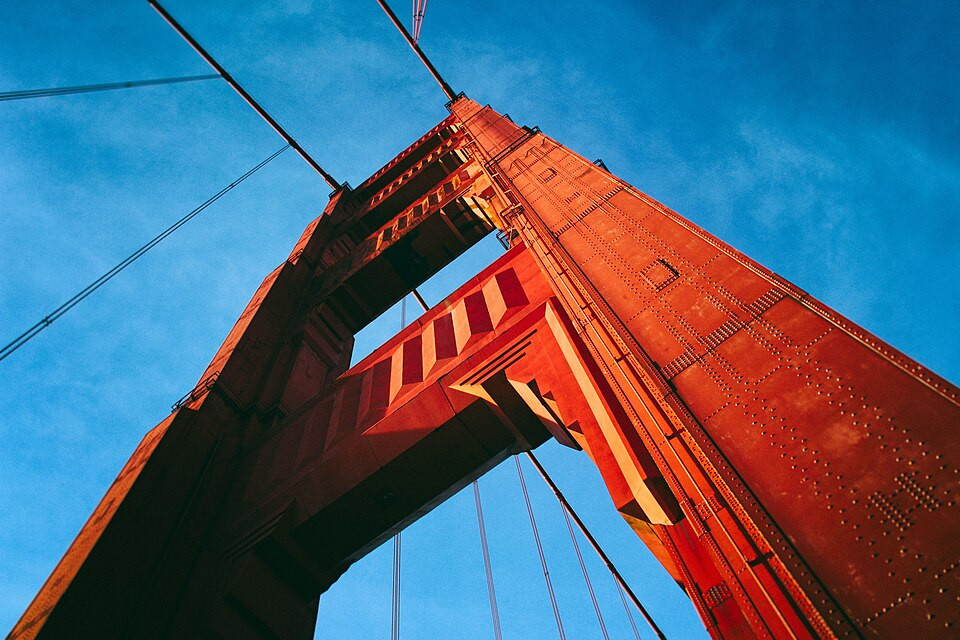
У нейросети спрашивают, как потратить десять долларов, и она советует проехать по мосту Золотые Ворота. Просят придумать любовную историю — получается рассказ об автомобиле, влюблённом в этот мост. Даже вопрос о собственной внешности снова приводит к красно-оранжевым башням над проливом. В мае 2024 года такая версия Claude действительно существовала. Но дело было не в хитром запросе пользователя.
Исследователи Anthropic изменили внутреннюю активность модели. Забавный результат стал наглядным примером серьёзной задачи: можно ли разобраться, какие представления возникают внутри нейросети, и проверить, как они влияют на ответ? История Golden Gate Claude интересна именно этим переходом от смешной реплики к эксперименту.
Не просьба сыграть роль
Обычный чат-бот тоже способен изображать мост, пирата или средневекового библиотекаря. Достаточно попросить его об этом. Однако в демонстрации Anthropic использовали другой подход: усиливали найденный внутренний признак, связанный с конкретной достопримечательностью. Модель начинала упоминать её даже там, где тема разговора этого не требовала.
В сообщении о демонстрации авторы специально отличали вмешательство от добавления инструкции и от дообучения на новой подборке текстов. Меняли не слова в запросе, а значения, возникающие во время вычисления ответа. Открытая демонстрация работала около суток; сейчас эта экспериментальная версия недоступна. Примеры выше пересказывают опубликованные описания, а не результаты нашего собственного теста.
Различие можно представить на условном примере. Одно дело — попросить экскурсовода рассказывать только о мостах. Другое — изменить работу механизма, который постоянно подсовывает ему связанные с мостом ассоциации. Это лишь поясняющее сравнение: эксперимент не доказывает, что у программы возникают человеческие переживания или навязчивые мысли.
Почему нельзя просто открыть нейросеть и прочитать её мысли
Разработчикам доступен программный код модели, но это не готовое объяснение каждого её ответа. Внутри идут численные вычисления. Наблюдатель видит множество значений активности, а не аккуратный список вроде «сейчас обсуждается путешествие», «здесь нужна шутка», «это неверное утверждение». Перевести эти значения на понятный человеку язык — отдельная исследовательская задача.
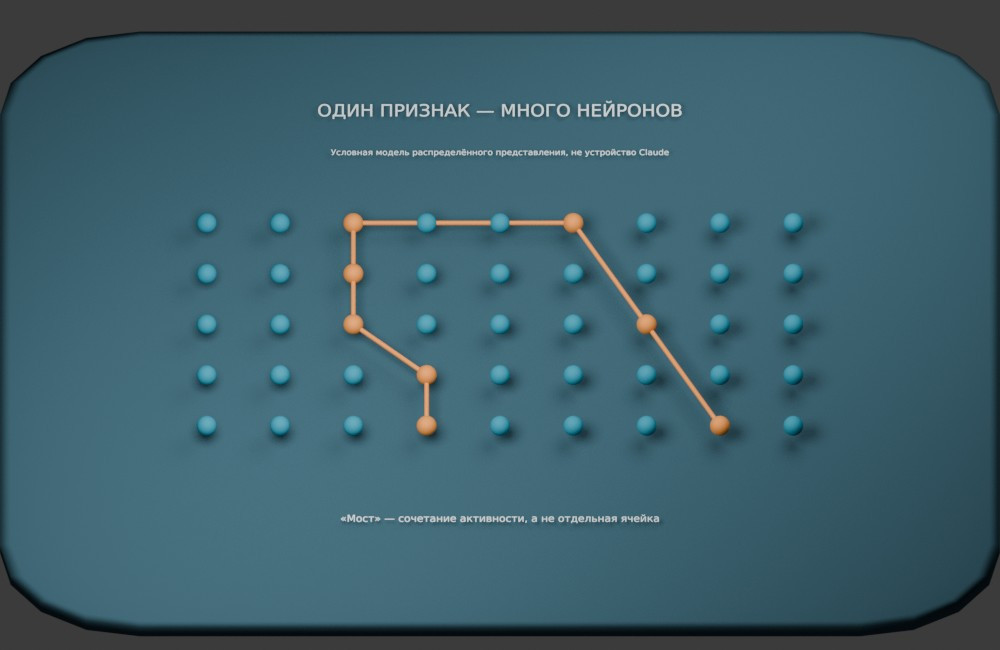
В работе о Claude 3 Sonnet использовали метод, который ищет повторяющиеся сочетания активности. Такие сочетания исследователи называют признаками. Они извлекли миллионы признаков из одного из средних слоёв модели, получив частичную карту её внутренних представлений. Это была именно версия Claude 3 Sonnet, а не описание устройства всех последующих моделей.
Удобная метафора — музыкальная запись. По отдельному отсчёту звуковой волны трудно понять, какой инструмент играет. Повторяющийся рисунок значений сообщает больше. Так же и смысловой признак нельзя автоматически приравнивать к одному нейрону. Метафора помогает увидеть задачу анализа, но не означает, что нейросеть буквально хранит оркестр готовых понятий.
Как нашли мост среди чисел
Для выделения признаков применяли разреженный автокодировщик: вспомогательную модель, которая учится представлять исходную активность через небольшой набор активных компонентов. Слово «разреженный» здесь означает, что в конкретном случае используется сравнительно малая часть доступного набора. Исследователи затем изучают, на каких входных данных компоненты становятся активными.
Среди результатов обнаружился признак, реагировавший на Золотые Ворота. Он срабатывал не только на английское название, но и на связанные описания на разных языках, а также изображения. Это делало находку интереснее простого распознавания одной последовательности букв. Внутреннее представление связывало разные способы упомянуть один объект.
Однако название признака — человеческая интерпретация наблюдений, а не этикетка, которую разработчик заранее приклеил внутри программы. Его границы могут не совпадать с границами понятия в нашем словаре. Поэтому подход требует проверок: какие примеры вызывают реакцию, какие не вызывают, сохраняется ли объяснение на новых данных?
От совпадения к проверке влияния
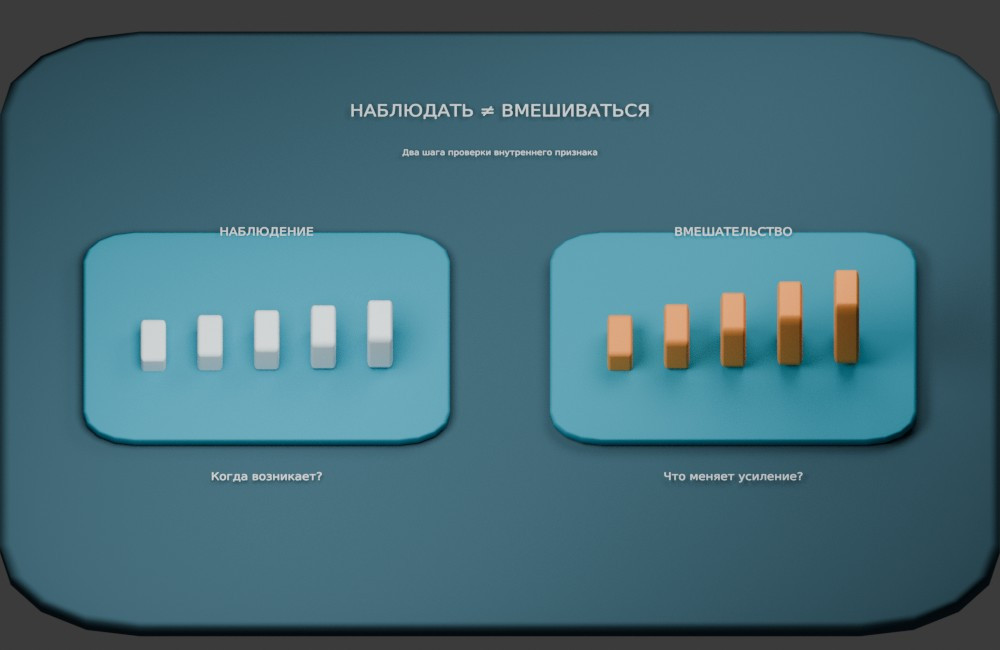
Замечать активность во время разговора о мосте недостаточно. Возможно, она лишь сопровождает обработку темы. Более сильная проверка — вмешаться и посмотреть, изменится ли поведение. Именно поэтому исследователи не остановились на поиске красивых соответствий между числами и словами.
Усиление выбранного признака сдвинуло ответы в сторону моста. Тем самым появилась причинная проверка: изменение внутреннего состояния заметно меняло результат. Это не полная расшифровка пути от вопроса к ответу, но уже больше, чем наблюдение «эти значения часто встречаются рядом с этим словом».
Представим прибор с неизвестными ручками. Если лампа загорается одновременно с поворотом одной ручки, можно заподозрить связь. Если при прочих одинаковых условиях её поворот снова и снова меняет свет, оснований становится больше. Но даже тогда мы ещё не знаем всю электрическую схему и не можем обещать, что соседние узлы останутся незатронутыми.
Почему это не пульт с кнопками «честность» и «безопасность»
Следующее исследование Anthropic, опубликованное в октябре 2024 года, проверяло управление 29 признаками, связанными с социальными предубеждениями. Результаты оказались неоднозначными. В определённых пределах вмешательство меняло ответы без большого ущерба для проверенных способностей; слишком сильное воздействие могло резко ухудшать работу модели.
Возникали и побочные эффекты. Признак, связанный в наблюдениях с одной темой, влиял на оценки в другой. Его название не всегда позволяло заранее предсказать направление изменения. Авторы также отмечали ограничения самих испытаний: тесты с вариантами ответов не охватывают всё многообразие настоящих разговоров.
Поэтому находка не означает, что достаточно выкрутить «ложь» на ноль и получить безошибочного помощника. Слово на условной ручке ещё не гарантирует точного, изолированного управления. Для практического применения важны не только эффектные примеры, но и устойчивость результата на разных задачах, отсутствие неожиданных изменений и воспроизводимость проверки.
А нейросеть действительно считала себя мостом?
Из текста ответа это установить нельзя. Фраза о собственной внешности показывает, что вмешательство изменило выдаваемые утверждения. Она сама по себе не подтверждает ни убеждений, ни самосознания, ни переживаний. В этой истории полезнее описывать наблюдаемое действие: программа стала отвечать определённым образом после определённого изменения.
В этом и состоит необычность опыта. Чтобы получить разговоры о мосте, не пришлось строить машину с человеческим характером. Достаточно было изменить численную составляющую её работы. А чтобы понять значение результата, пришлось выйти за пределы самих разговоров и исследовать механизм.
Golden Gate Claude запомнился нелепой одержимостью достопримечательностью. Но научная ценность демонстрации не в шутке «AI сошёл с ума». Она в возможности задавать проверяемый вопрос: если изменить конкретную часть внутренней активности, что произойдёт с ответом? Такой вопрос не раскрывает весь чёрный ящик разом, зато позволяет изучать его по частям.
Источники и иллюстрации
- Anthropic: Golden Gate Claude, 23 мая 2024.
- Mapping the mind of a large language model, 21 мая 2024.
- Templeton и соавторы: Scaling Monosemanticity, 2024.
- Evaluating feature steering, 25 октября 2024.
- Фото моста: Ramiro Checchi, Wikimedia Commons, CC0. Уменьшено. Объёмные схемы созданы для этой статьи; это поясняющие модели, не изображения реальной архитектуры Claude.