

Вы несколько вечеров писали текст, переставляли абзацы, вычёркивали неудачные фразы. Затем кто-то загрузил результат в «детектор нейросетей», и на экране появилась уверенная отметка: текст создан AI. Возникает странная ситуация — человек помнит, как работал, а программа будто знает о его работе больше него.
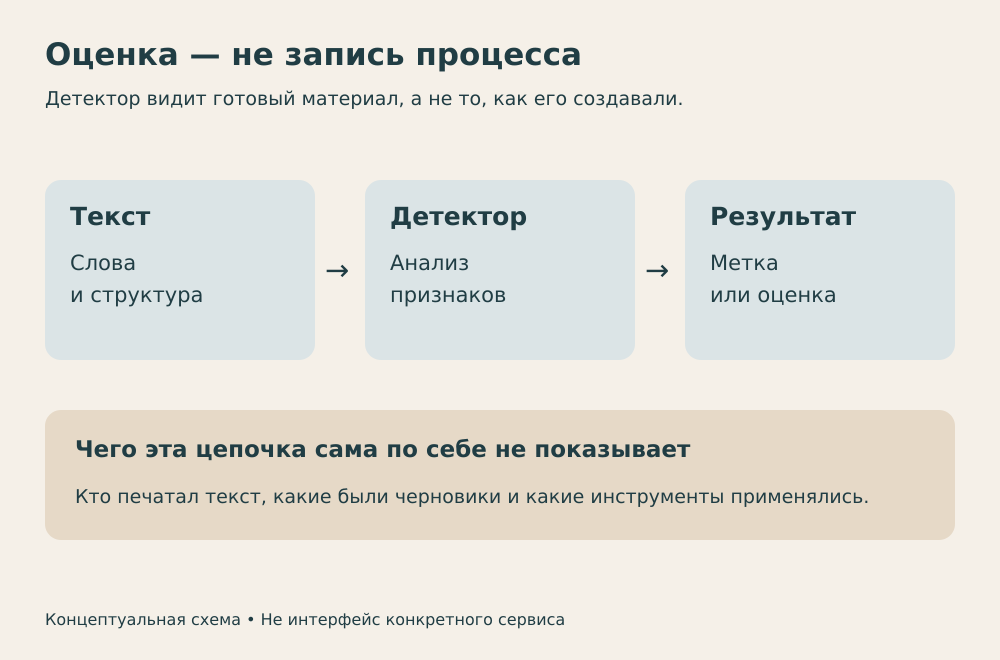
Но детектор не сидел рядом с автором и не наблюдал за клавиатурой. В обычной проверке по готовому тексту он оценивает признаки, а не восстанавливает запись процесса. Между «похоже на машинный текст» и «это написал AI» лежит важный логический шаг. Именно на нём возможны ошибки.
Показательный опыт с английскими сочинениями
В исследовании 2023 года учёные из Стэнфорда проверили семь доступных тогда детекторов. Среди материалов были 91 человеческое сочинение TOEFL, взятое с китайского образовательного форума, и 88 работ американских восьмиклассников. Для первой группы английский был неродным языком. Системы гораздо чаще ошибочно записывали её тексты в машинные.
Особенно наглядная деталь: 18 из 91 сочинения TOEFL все семь проверенных детекторов сочли созданными AI. Это не предполагаемые мошенники, пойманные семью независимыми свидетелями. В эксперименте именно человеческие тексты получили ошибочную метку. Совпадение нескольких вердиктов само по себе не превратило её в доказательство.
Границы результата принципиальны: речь о выбранных системах, образцах английского и условиях 2023 года. Исследование не измеряло качество всех нынешних детекторов, не проверяло русский язык и не утверждало, что любой текст человека, пишущего на неродном языке, обязательно будет отмечен. Авторы отдельно указывали на сравнительно небольшие выборки и необходимость более широких проверок.
Почему простой стиль может вызвать подозрение
Одна из обсуждаемых в работе характеристик — perplexity, которую можно приблизительно описать как меру неожиданности текста для языковой модели. Если последовательность слов для неё сравнительно предсказуема, показатель ниже. Это не школьная отметка за красоту, ум или самостоятельность автора.
Исследователи связывали наблюдавшиеся ошибки с ограниченным разнообразием языковых выражений. Человек, пишущий на неродном языке, может выбирать знакомые слова и конструкции; определённый детектор способен принять такую предсказуемость за машинный след. Это объяснение изученного эффекта, а не правило о том, как говорят все неносители языка.
Представим собственный условный пример: два человека описывают один маршрут. Один пишет коротко и прямо, второй добавляет образные сравнения. Различие стиля ничего не сообщает о том, держал ли кто-то из них открытым чат-бота. Лаконичный автор мог тщательно выбирать каждое слово. Пышная фраза тоже могла появиться автоматически.
Соблазн объявить узнаваемый оборот «печатью нейросети» понятен. Но люди пользуются клише, редакторы выравнивают интонацию, а учебные задания часто требуют стандартной структуры. Само сходство с шаблоном ещё не объясняет, откуда взялся конкретный текст. Это основание задать вопрос, но не готовый ответ.
Две ошибки, которые легко перепутать
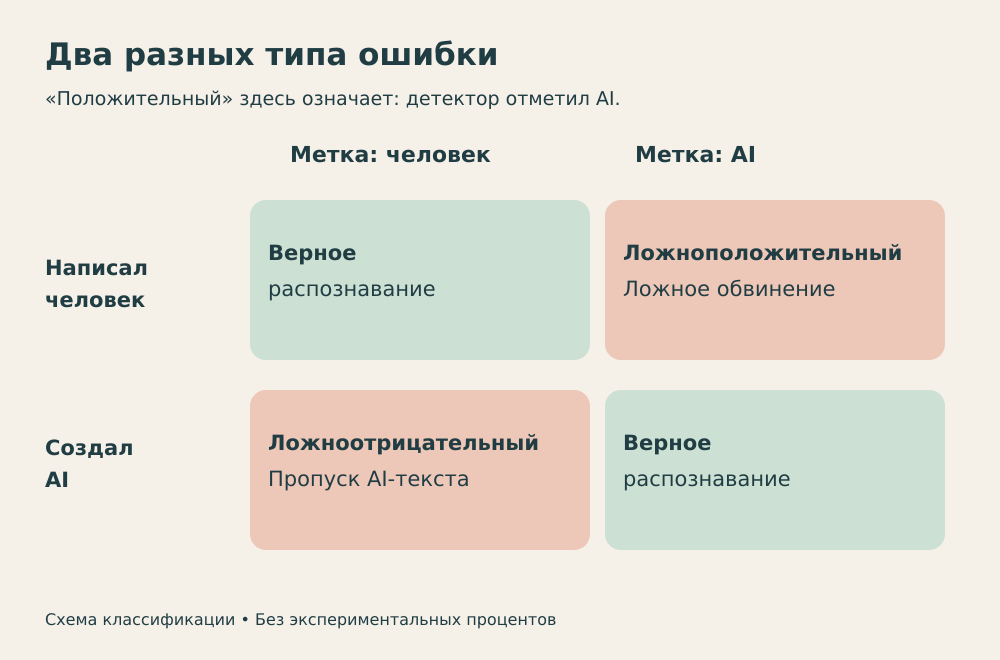
Ложноположительный результат — программа решила, что AI был, хотя текст написал человек. Ложноотрицательный — машинный текст прошёл как человеческий. Оба случая являются ошибками, но последствия у них разные. В первом рискуют несправедливо обвинить автора, во втором — пропустить нарушение правил, если использование AI было запрещено.
Рекламная фраза «высокая точность» без условий не помогает разобраться. Полезно знать, на каком языке и жанре тестировали систему, как длинны были образцы, какие генераторы использовали и какие именно ошибки считали. Результат на одном наборе нельзя автоматически считать обещанием для любого письма, сочинения или научной статьи.
И процент на экране тоже нужно читать по документации конкретного сервиса. Это может быть оценка классификатора или доля отмеченных фрагментов. Нельзя без объяснения разработчика трактовать его как вероятность того, что автор солгал. Красочная шкала делает заключение наглядным, но не добавляет ему недостающих оснований.
Даже редкая ошибка может дать много ложных тревог
Проверим это на полностью вымышленном расчёте, не связанном с конкретным сервисом. В наборе 1000 человеческих текстов и 10 машинных. Допустим, детектор ошибочно отмечает один человеческий текст из ста, а среди машинных находит девять из десяти. Тогда он выдаст 10 ложных тревог и 9 верных. Среди 19 отмеченных работ человеческих окажется больше половины — несмотря на то, что обе исходные характеристики выглядели неплохо.
Причина не в парадоксе и не в подлоге: человеческих текстов в примере гораздо больше. Поэтому вопрос «как часто система ошибается на человеческих работах?» не равен вопросу «какая доля её обвинений ошибочна?». Для второго нужно учитывать состав проверяемого набора. Это ещё одна причина не превращать красивую общую оценку качества в вывод о конкретном авторе.
Проблему признавали и разработчики
В июле 2023 года OpenAI сняла с публичного доступа свой текстовый классификатор из-за недостаточной точности. В описании инструмента компания предупреждала о ложных срабатываниях, низкой надёжности на коротких текстах и худшей работе на языках, отличных от английского. Она также не рекомендовала использовать его как главный инструмент принятия решений.
Это история конкретного продукта, а не доказательство бессмысленности любого будущего метода. Но она хорошо показывает разницу между полезным исследовательским сигналом и устройством для вынесения окончательного вердикта. Чтобы судить о новом сервисе, нужны его собственные проверки, а не доверие к слову «детектор».
Почему три проверки не всегда лучше одной
Если три человека повторили одну и ту же непроверенную новость, мы не получили три независимых подтверждения. С автоматическими оценками возможна похожая логическая ловушка: разные сервисы могут опираться на сходные признаки и ошибаться на похожих текстах. Их согласие стоит изучить, но простое голосование не делает установление авторства безошибочным.
Обратная ситуация тоже не решает вопрос. Если один сервис дал зелёную отметку, а другой красную, нельзя просто выбрать удобный результат. Несогласие показывает, что одного такого способа недостаточно для уверенного вывода. Переписывание текста до желаемого цвета превращает обсуждение авторства в игру со шкалой и не восстанавливает реальную историю работы.
Что обсуждать вместо «мне так показал сайт»
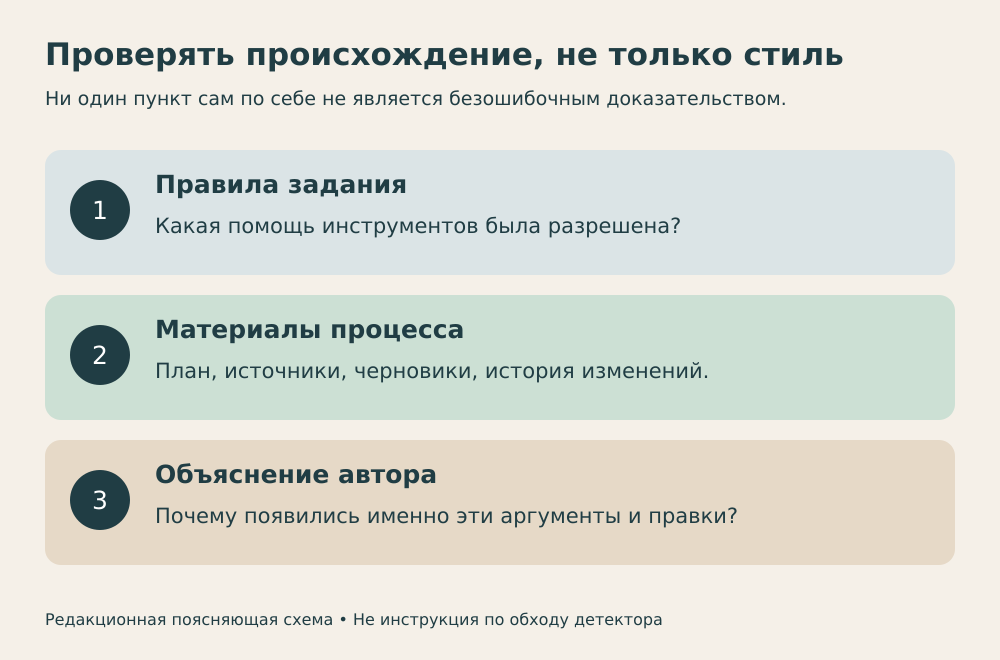
Практический вывод — отделить сигнал проверки от обвинения. При споре полезнее обсудить происхождение текста: рабочий план, сохранившиеся черновики, историю изменений, использованные источники и объяснение авторских решений. Эти материалы не являются волшебным сертификатом подлинности, но относятся к процессу работы, а не только к внешнему виду результата.
Например, автор может объяснить, почему перестроил аргумент или убрал абзац, и показать, как уточнял источник. Проверяющий может попросить разобрать конкретный спорный фрагмент. Разговор становится содержательнее, чем обмен скриншотами с процентами. При этом отсутствие сохранённых черновиков само по себе тоже не доказывает применение AI.
Наконец, стоит заранее определять правила: разрешена ли проверка орфографии, перевод, обсуждение плана, генерация отдельных абзацев? Между «написал всё сам без инструментов» и «целиком вставил готовый ответ» много разных процессов. Если правила смешивают их в одну категорию, даже технически совершенная отметка не объяснит, какое именно требование нарушено.
Детектор может поставить метку за секунду. Установить, как появился текст, сложнее. Поэтому главный урок стэнфордского исследования не в том, что любому AI нужно запретить анализировать сочинения. Он в другом: особенности языка человека не должны незаметно превращаться в доказательство его нечестности.
Источники и иллюстрации
- Liang и соавторы. GPT detectors are biased against non-native English writers — исследование 2023 года, версия v3 от 10 июля.
- Stanford HAI: разбор исследования детекторов и неносителей английского.
- OpenAI: ограничения текстового классификатора и уведомление о прекращении его доступности 20 июля 2023 года.